Vurdering inden revision:
Artiklen er allerede over middel for genren. Tre-niveau-frameworket, tabellen med tyve eksempler og grøn/gul/rød-modellen består 2.000 kr-testen. Det svage punkt er afsnittet "Tre niveauer: fri, intern, beskyttet". De tre under-afsnit er solide, men intro-afsnittet over dem er generisk. "Problemet er, at den sjældent er skrevet til den medarbejder.." er fyld. Resten bevares eller strammes minimalt.
Din kollega vil paste jeres kundeliste ind i ChatGPT for at lave en segmentering. Din praktikant vil uploade et regneark med sælgernes provision for at få hjælp til en graf. Begge dele lyder fornuftigt, og begge dele kan være en fejl. Forskellen handler ikke om, hvad AI kan, men om hvilke data I fodrer den med. Denne artikel giver dig et datakort med tre niveauer og tyve konkrete eksempler, så du kan svare klart, når kollegaen spørger: "Må jeg bruge det her?"
Indholdsfortegnelse
- Hovedpointer
- Hvorfor dataklassifikation hører til i jeres AI-politik
- Tre niveauer: fri, intern, beskyttet
- Datakortet: tyve eksempler fordelt på tre niveauer
- Hvad gør man med det midterste niveau?
- Sådan bruger I kortet i praksis
Hovedpointer
- Tre niveauer er nok: Frie data (allerede offentlige), interne data (ikke hemmelige, men heller ikke jeres at dele) og beskyttede data (personoplysninger og alt under aftale).
- Det midterste niveau er der, fejlene sker. Omsætning pr. kunde, løntal, udkast til pressemeddelelser: det er ikke hemmeligt, men det er heller ikke noget, der skal ligge hos en ekstern AI-udbyder.
- Dataklassifikation er en forudsætning for jeres AI-politik. Uden den ved ingen, hvad de må, og I ender med enten nul-tolerance eller vilde vesten.
- Kortet er et arbejdsredskab, ikke juridisk rådgivning. Brug det som udgangspunkt, og tilpas det til jeres egen virkelighed.
Hvorfor dataklassifikation hører til i jeres AI-politik
En AI-politik uden dataklassifikation er som en køreplan uden hastighedsgrænser. Folk ved, de skal køre, men ikke hvor hurtigt. Resultatet er enten, at ingen tør bruge AI, eller at nogen uploader noget, de ikke burde.
Når vi hjælper organisationer med at færdiggøre deres AI-politik, er datakortet ofte det første dokument, vi laver. Ikke fordi det er det mest spændende, men fordi det besvarer det spørgsmål, medarbejdere faktisk stiller: "Må jeg bruge det her?"
AI-forordningen (EU AI Act) stiller i artikel 4 krav om, at medarbejdere har tilstrækkelige AI-færdigheder. At vide, hvilke data man må og ikke må lægge i et AI-system, er en helt grundlæggende del af den færdighed. For en komplet gennemgang af, hvad den nye lovgivning betyder for jeres virksomhed, se vores artikel, der forklarer EU AI Act.
Tre niveauer: fri, intern, beskyttet
De tre niveauer er skrevet i hverdagssprog, ikke til IT-sikkerhedsauditoren, men til den medarbejder, der sidder med ChatGPT åben og er i tvivl.
Niveau 1: Frie data. brug AI frit
Information, der allerede er offentlig, eller som I bevidst har gjort offentlig. Tænk på det som alt det, I ville lægge på jeres hjemmeside eller i en pressemeddelelse.
Hvad det betyder i praksis: Du kan bruge disse data i alle AI-værktøjer, gratis som betalte, uden særskilt godkendelse. Der er intet at beskytte, fordi der intet er at skjule.
Eksempel på en tilladt opgave: Du kopierer teksten fra jeres seneste publicerede årsrapport ind i ChatGPT og beder den lave et resumé til jeres nyhedsbrev. Det er frit.
Niveau 2: Interne data. brug AI med godkendt værktøj
Her bliver det interessant, for det er dette niveau, de fleste glemmer. Interne data er ikke hemmelige, men de er heller ikke jeres at dele med en ekstern tjeneste. Det er tal, andre aflønnes efter. Udkast, der endnu ikke er godkendt. Analyser, der giver konkurrencefordel.
Hvad det betyder i praksis: Du må bruge disse data i AI-værktøjer, der er godkendt af jeres organisation, typisk fordi der er en databehandleraftale, og data ikke bruges til træning. Du må ikke bruge dem i gratis, ubeskyttede versioner.
Eksempel på en tilladt opgave: Din salgschef uploader pipeline-arket med omsætning pr. kunde i ChatGPT Enterprise (med databehandleraftale). Det er tilladt. Samme ark i den gratis version af ChatGPT er ikke tilladt.
Eksempel på en ikke-tilladt opgave: Praktikanten uploader regnearket med sælgernes individuelle provisionstal i den gratis version af Claude for at få hjælp til en graf. Tallene er ikke personfølsomme i GDPR-forstand, men de er forretningskritiske og indeholder lønrelaterede oplysninger. Det er et niveau 2-brud.
Niveau 3: Beskyttede data. brug ikke AI uden juridisk vurdering
Personoplysninger, sundhedsdata, data under NDA og alt der er reguleret af GDPR eller sektorlovgivning. Disse data må som udgangspunkt ikke lægges i et eksternt AI-system uden en databehandleraftale og en konkret vurdering.
Hvad det betyder i praksis: Selv med databehandleraftale kræver disse data en specifik GDPR-vurdering, inden I bruger dem i et AI-system. Standardsvaret er nej, og undtagelsen kræver aktiv beslutning fra den dataansvarlige.
Eksempel på en ikke-tilladt opgave: En HR-medarbejder uploader et regneark med medarbejdernes navne, stillingsbetegnelser og løn i ChatGPT for at finde mønstre i lønstrukturen. Kombinationen af navn og løn er persondata. Det må ikke ske, hverken i gratis eller betalte versioner, uden en konkret GDPR-vurdering er gennemført og dokumenteret.
For en dybere forståelse af AI og GDPR kan du læse vores ultimative tryghedsguide.
Datakortet: tyve eksempler fordelt på tre niveauer
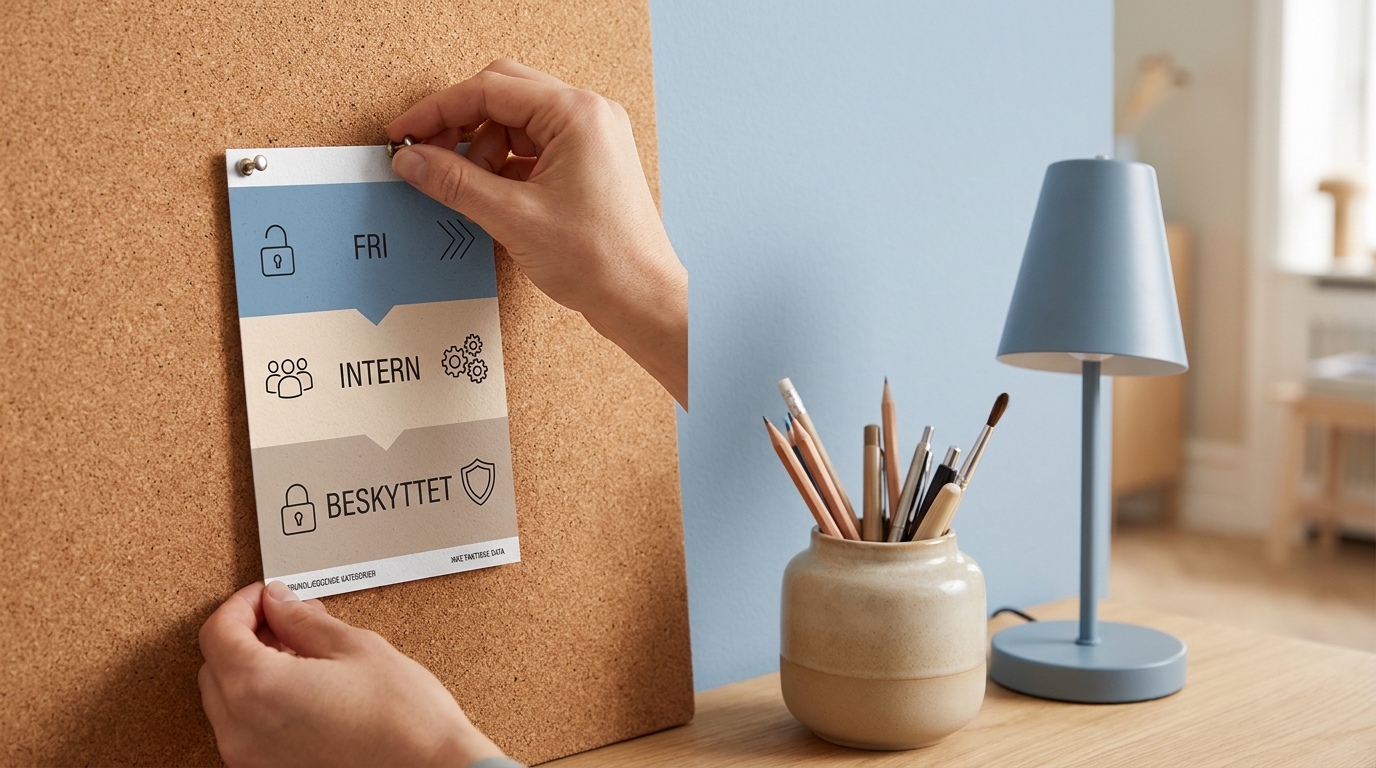
Brug tabellen som udgangspunkt. Kopiér den, tilpas den til jeres organisation, og hæng den op der, hvor folk faktisk sidder og arbejder.
| Niveau | Eksempel | Bemærkning |
|---|---|---|
| Fri | Publiceret årsrapport | Allerede offentlig |
| Fri | Produktbeskrivelser fra jeres hjemmeside | Offentligt tilgængeligt |
| Fri | Offentliggjort pressemeddelelse | Bevidst offentliggjort |
| Fri | Generelle branchetal fra offentlige kilder | Ikke jeres data |
| Fri | Jobopslag, I har slået op | Allerede offentligt |
| Fri | Jeres offentlige vedtægter eller formålsbeskrivelse | Offentligt tilgængeligt |
| Intern | Omsætning pr. kunde | Forretningskritisk, ikke persondata |
| Intern | Sælgernes individuelle salgstal | Tal, andre aflønnes efter |
| Intern | Udkast til pressemeddelelse (ikke godkendt) | Kan flytte markedet eller skade omdømme |
| Intern | Intern strategiplan | Konkurrencefølsom |
| Intern | Medlemstal fordelt på segmenter | Ikke offentligt, men ikke personhenførbart |
| Intern | Budget og forecast for næste kvartal | Forretningskritisk |
| Intern | Leverandørpriser og rabataftaler | Kommercielt følsomt |
| Intern | Referat fra ledermøde | Intern beslutningsproces |
| Beskyttet | Medarbejdernes CPR-numre | Persondata, GDPR |
| Beskyttet | Kundeliste med kontaktoplysninger | Persondata, GDPR |
| Beskyttet | Lønoplysninger med navne | Persondata og kommercielt følsomt |
| Beskyttet | Helbredsoplysninger fra HR-sager | Følsom persondata, GDPR |
| Beskyttet | Data under NDA med samarbejdspartner | Kontraktligt bundet |
| Beskyttet | Borgeres sagsoplysninger (offentlig sektor) | Persondata, GDPR |
Hvad gør man med det midterste niveau?
Det midterste niveau kræver to konkrete afklaringer, ikke bare god vilje. Her er de begge med eksempler på, hvad svaret faktisk ser ud:
1. Hvor havner data?
Svaret afhænger af, hvilket værktøj I bruger, og det er ikke nok at antage. Her er tre typiske scenarier:
- Gratis ChatGPT (uden login eller med gratis konto): Data kan bruges til at forbedre modellen. Interne data hører ikke hjemme her.
- ChatGPT Team eller Enterprise: OpenAI bruger ikke data til træning, og I har en databehandleraftale. Interne data er typisk acceptable efter en intern godkendelse.
- Microsoft Copilot via jeres Microsoft 365-licens: Data behandles inden for jeres egen Microsoft-tenant og forlader ikke jeres miljø. Interne data er typisk acceptable.
Tommelfingerreglen: Har I underskrevet en databehandleraftale med udbyderen, og bruges data ikke til træning? Så kan interne data typisk bruges. Er svaret uklart, er svaret nej.
2. Hvem beslutter?
Datakortet skal pege på en person eller en rolle, der kan svare, når nogen er i tvivl. En CFO, der manuelt konsoliderer data fra fire systemer hver måned, vil naturligt nok gerne bruge AI til at spare tid. Det er et legitimt ønske. Men beslutningen om, hvorvidt konsolideringen må foregå i et eksternt værktøj, skal være taget på forhånd, ikke midt i et regneark.
Udpeg én rolle, ikke en afdeling, men en konkret titel, og skriv det ind i kortet. "Spørg IT-sikkerhedsansvarlig" er et acceptabelt svar. "Spørg nogen" er ikke.
Sådan bruger I kortet i praksis
Tre trin, der tager en formiddag:
Trin 1: Kopiér tabellen og gør den til jeres.
Tag de tyve eksempler og gå dem igennem med den person, der har ansvar for GDPR eller IT-sikkerhed. Marker dem, der er relevante for jeres organisation. Tilføj de datatyper, I faktisk arbejder med til daglig: kundekontrakter, tilbudsark, interne evalueringer, hvad der nu er jeres hverdag. Stryk dem, der ikke giver mening i jeres kontekst.
Resultatet er et datakort, der er skrevet til jer, ikke til en generisk virksomhed.
Trin 2: Sæt en ansvarlig på niveau 2.
Skriv et navn eller en titel ind i kortet: "Er du i tvivl om niveau 2, spørg [navn/rolle]." Det behøver ikke være en jurist. Det skal bare være en person, folk ved, de kan spørge, og som har mandat til at sige ja eller nej.
Trin 3: Kobl kortet til jeres værktøjsliste med en grøn/gul/rød-model.
Et datakort uden en værktøjsliste er halvt arbejde. Grøn/gul/rød-modellen ser sådan ud i praksis:
| Farve | Betyder | Eksempel |
|---|---|---|
| Grøn | Godkendt til alle dataniveauer | Copilot via jeres Microsoft 365-tenant |
| Gul | Godkendt til niveau 1 og 2, ikke niveau 3 | ChatGPT Enterprise med databehandleraftale |
| Rød | Kun niveau 1. frie, offentlige data | Gratis ChatGPT, gratis Claude, gratis Gemini |
Hæng listen ved siden af datakortet, fysisk eller som fastgjort dokument i Teams eller intranet. Når praktikanten spørger, peger du på to ting: hvilken farve har værktøjet, og hvilket niveau har dataene. Matcher de, er svaret ja. Matcher de ikke, er svaret nej.
Vi har skrevet mere om det i vores guide til AI-værktøjslisten og den grøn/gul/rød-model.
En vigtig pointe: kortet er et arbejdsredskab, ikke juridisk rådgivning. Det erstatter ikke jeres GDPR-vurdering eller jeres juridiske afdeling. Det giver medarbejderne et sprog og en ramme, så de kan tage de rigtige beslutninger i hverdagen.
Ofte stillede spørgsmål

Bruno Poulsen er partner i Poulsen & Vinding, et konsulenthus der hjælper danske virksomheder og styrelser med at tage generativ AI i brug i den daglige drift. Han har undervist hos Bigum&Co i mere end 10 år og har siden 2023 stået bag AI-implementeringer, foredrag og workshops for blandt andre Lægemiddelstyrelsen, GS1 Danmark, Bornholms Højskole og 30+ bornholmske SMV’er via Business Center Bornholm. Skriver om praktisk anvendelse af AI-værktøjer, prompt engineering og hvordan ledelser kommer i gang mandag morgen kl. 08.00.